H200在算力方面整体优于H100在内存带宽上H100与H200算力对比生态分析,H100和H200均基于英伟达Hopper架构H100与H200算力对比生态分析,H100配备HBM3高带宽内存。
总体上,H200在内存带宽和特定浮点运算算力上超越H100在内存带宽方面,H100配备HBM3高带宽内存,内存带宽。
H200芯片在显存带宽单精度浮点运算性能算力系统配置应用场景及功耗特性等方面较H100有显著提升具体表现如下显存和带宽方面,H200配备HBM高带宽内存架构,搭载HBM3e技术,实现141GB内存容量和48TB秒带宽与H100相比,其内存容量提升18倍,带宽提升14倍,内存带宽更是达到A100H100与H200算力对比生态分析的24倍这。
3算力参数方面,FP32单精度算力H200为195 TFLOPS,H100为197 TFLOPS,差异极小,FP16混合精度算力H200为39 TFLOPS,H100为397 TFLOPS,比较接近,但是H200的Transformer引擎性能提升约2倍,针对大模型推理优化明显二性能表现1大模型训练时,H200在7B13B70B等主流大模型训练中,速度比H100。
2H200基于40平方毫米的台积电4N工艺,H100是80平方毫米的台积电4工艺,H200晶体管密度更高,性能密度提升显著二性能参数情况1H200的FP8浮点算力达300 TFLOPS,H100为1979 TFLOPS,H200的AI训练速度提升约66%H200的FP32算力为1979 TFLOPS与H100一样,但能效比更出色2两者都支持HBM3e显存。
2 显存差异H200配备141GB HBM3e显存带宽335TBs,而H100为80GB HBM3显存带宽3TBs,显存容量和带宽分别提升76%12%,大幅缓解大模型训练推理时的显存瓶颈3 算力参数FP32单精度算力H200为195 TFLOPSH100为197 TFLOPS,差异极小FP16混合精度算力H200为3。
英伟达发布新一代H200芯片将为相关产业带来显著发展机遇,尤其在AI算力需求激增的背景下,硬件升级生态链协同及垂直领域应用将形成多层次推动效应具体分析如下一H200核心升级点直接解决AI发展痛点内存容量与带宽的突破性提升 H200采用HBM3e内存,容量达141GBH100为80GB,带宽提升至48TBsH100。
2 显存差异H200配备141GB HBM3e显存带宽335TBs,而H100为80GB HBM3显存带宽3TBs,显存容量和带宽分别提升76%12%,大幅缓解大模型训练推理时的显存瓶颈3 算力参数FP32单精度算力H200为195 TFLOPSH100为197 TFLOPS,差异极小FP16混合精度算力H200为39 TFLOPSH100。
英伟达H200和H100相比,核心差异主要在显存升级,算力相近,能更好适配大模型推理与训练需求一核心参数对比1H100有80GB HBM3显存,带宽335TBsH200有141GB HBM3e显存,容量提升76%,带宽48TBs,提升43%2两者FP8峰值算力约989 TFLOPS,FP16约494 TFLOPS,核心算力差异不明显3都是。
英伟达H200与H100的核心差异集中在显存升级,算力保持相近,更适配大模型推理与训练需求一核心参数对比关键差异1 显存规格#8226 H10080GB HBM3显存,带宽335TBs#8226 H200141GB HBM3e显存容量提升76%,带宽48TBs提升43%2 算力水平#8226 两者FP8峰值算力均约989。
一计算能力方面H100基于英伟达新一代的Hopper架构,其拥有更高的算力它在FP64双精度浮点运算性能上相比前代有显著提升,能更高效地处理复杂科学计算等对双精度要求高的任务而H200尽管也有一定计算能力提升,但在整体计算规模和效率上与H100相比有差距比如在一些大规模数据的深度学习训练场景中。
H200作为H100的升级版,主要提升体现在显存容量和显存带宽上,算力性能与H100基本一致,其核心升级源于HBM3到HBM3e的迭代以下是具体分析核心提升点HBM3e带来的显存与带宽升级显存容量提升H200将H100的HBM3升级为HBM3e,显存容量从H100的80GB4颗20GB HBM3提升至141GB实际可能因量产冗余。
一计算能力H100基于英伟达新一代架构,其计算核心的性能有显著提升它拥有更高的算力,能够在更短时间内完成复杂的计算任务,比如大规模的数据处理深度学习模型的训练等相比之下,H200虽然也具备一定计算能力,但在绝对性能上逊于H100例如在处理一些超大规模的矩阵运算时,H100可以凭借其更强大的。
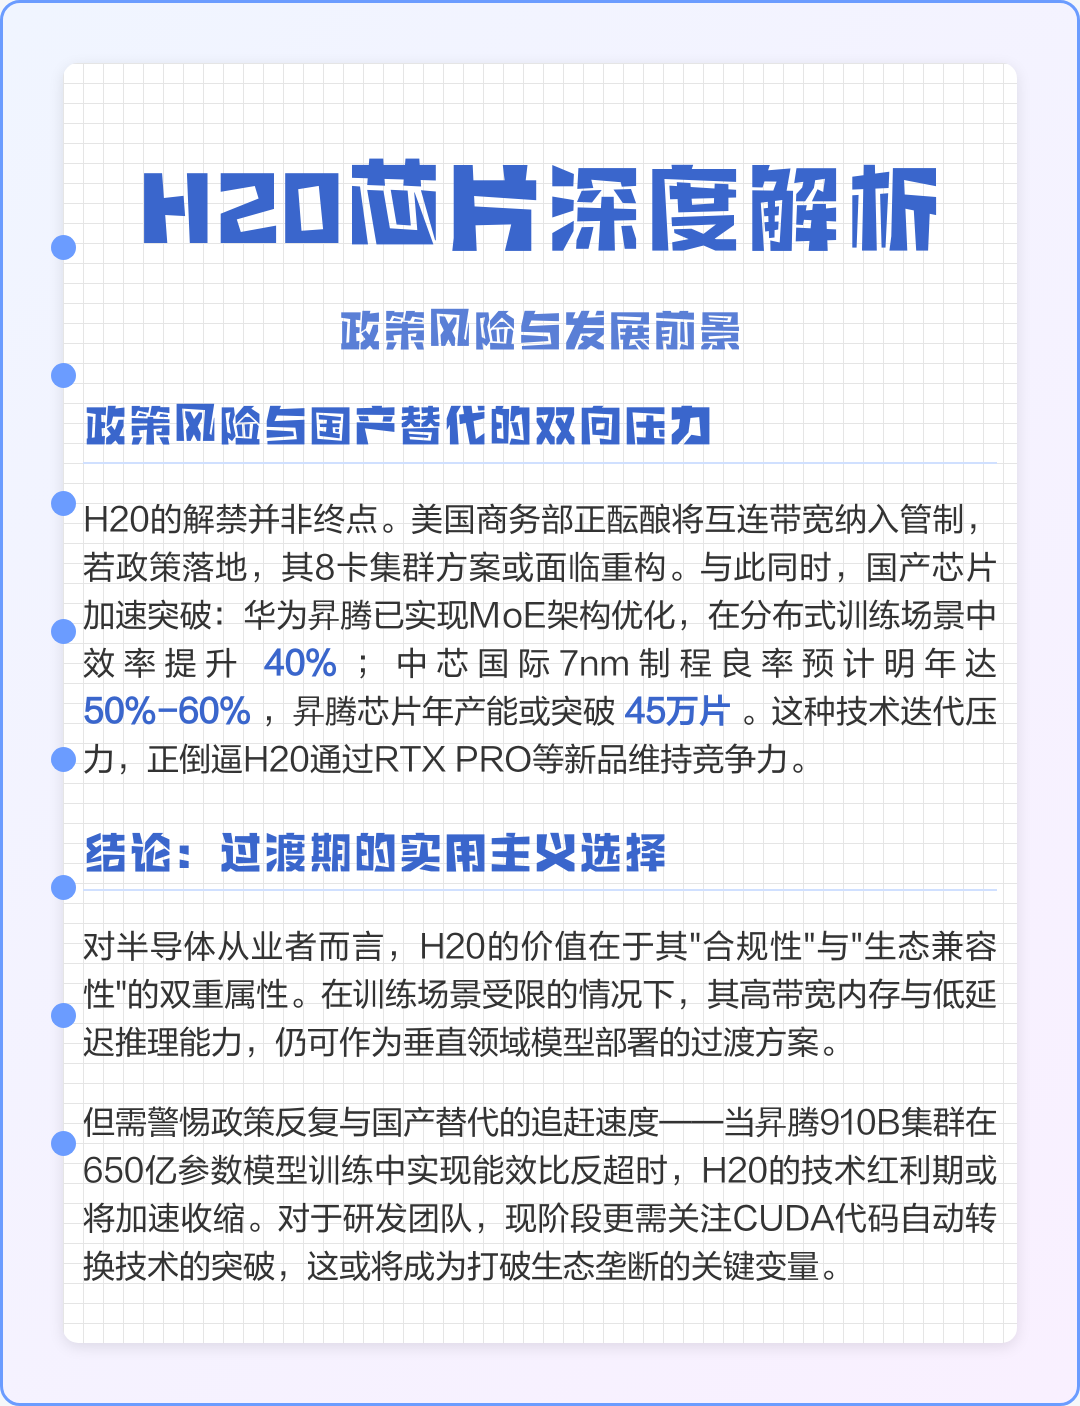
H200在性能上弱于H100,且在推理性能实测中显著落后于B300以下从不同维度展开对比分析与H100的对比H200作为H100的“阉割版”,在核心性能指标上存在明显差距显存方面,H200的显存容量和带宽均被限制,导致大模型训练时数据吞吐能力不足,直接影响训练效率互联带宽的降低进一步限制H100与H200算力对比生态分析了多卡协同训练的扩展。
一计算能力提升H200相比H100有显著的计算能力增强它采用了更新的架构和制程工艺,能够提供更高的算力例如在一些复杂的深度学习训练任务中,H200可以更快速地完成数据处理和模型计算,大大缩短训练时间二内存带宽优化H200在内存带宽方面有了进一步优化更高的内存带宽使得数据的读取和写入速度更快。